標準曲線與線性迴歸 Curve Fitting: Linear Regression, r & r², Inverse Prediction
儀器只會給你「峰面積」,但法規要的是「濃度」。中間那道換算手續——標準曲線——做錯一步,後面全部白算。
本章新詞先認識:最小平方法=找最佳直線的數學;r²=點貼線的程度(愈接近 1 愈好);殘差=每個點離線多遠;外插=超出資料範圍亂延伸(危險!)。
名詞卡住了?回 Ch0 名詞圖鑑 查白話解釋與比喻。
- 會用 R 的 lm() 建立標準曲線 y = ax + b
- 會解讀相關係數 r 與判定係數 r²,知道 r ≥ 0.997 的經驗法則
- 會看殘差圖與信賴帶,判斷直線假設是否成立
- 會由未知樣品訊號反推濃度,並知道外插的危險
- 知道殘差呈喇叭狀(變異隨濃度變大)時要改用加權迴歸
lm(..., weights = 1/x)或1/x^2,並用低濃度的回算偏差(而不是 r²)選權重
4.1 標準曲線:儀器分析的靈魂
儀器(HPLC、AA、光譜儀…)量到的是訊號(波峰面積、吸光度), 我們要的是濃度。做法:配一組已知濃度標準品 → 測訊號 → 擬合直線 → 未知樣品的訊號反推濃度。
4.2 最小平方迴歸:lm()
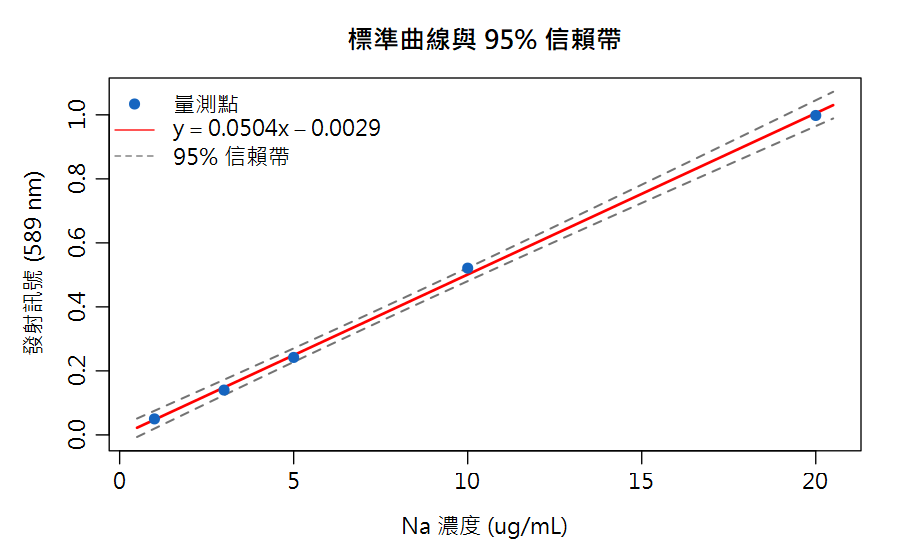
Nielsen 章末習題 4(鈉標準曲線 Group A): 濃度 x = 1, 3, 5, 10, 20 μg/mL,發射值 y = 0.050, 0.140, 0.242, 0.521, 0.998。 迴歸結果 y = 0.0504x − 0.0029,r² = 0.9990(與課本解答一致)。
4.2.1 動手做:R 與 Excel 算出同一條線
同一組數據,用兩種工具各做一次——結果會一模一樣,這就是「統計方法是相通的」最好的證明。
在 R 中,主要使用 lm() (Linear Model) 函數來進行線性迴歸。
# 1. 建立數據向量
x <- c(1, 3, 5, 10, 20)
y <- c(.050, .140, .242, .521, .998)

# 2. 建立線性迴歸模型 (y 對 x)
fit <- lm(y ~ x)

# 3. 取得方程式參數
coef(fit)                       # 輸出截距 (-0.0029) 與斜率 (0.0504)
summary(fit)$r.squared          # 輸出 r² (0.9990)
cor(x, y)                       # 輸出 r (0.9995)

# 4. 反推未知濃度 (假設未知樣品訊號為 0.555)
# 公式:x = (y - 截距) / 斜率
(0.555 - coef(fit)[1]) / coef(fit)[2]   # 算出濃度約 11.07 μg/mL
> coef(fit)
(Intercept)           x
-0.002915945 0.050399480
> summary(fit)$r.squared
[1] 0.9990253
> cor(x, y)
[1] 0.9995125
> (0.555 - coef(fit)[1]) / coef(fit)[2]
      x
11.06988把濃度輸入 A1:A5、發射值輸入 B1:B5,可以利用內建函數或圖表功能來快速求得直線方程式:
| 結果 | Excel 公式解法 |
|---|---|
| 斜率 a | =SLOPE(B1:B5,A1:A5) → 0.0504 |
| 截距 b | =INTERCEPT(B1:B5,A1:A5) → −0.0029 |
| r² | =RSQ(B1:B5,A1:A5) → 0.9990 |
| r | =CORREL(A1:A5,B1:B5) → 0.9995 |
| 反推濃度 (訊號 0.555) | =(0.555−INTERCEPT(...))/SLOPE(...) → 11.07 |
1. 選取 A、B 兩欄數據 → 插入「散佈圖」。
2. 對任一點按右鍵選「加上趨勢線」。
3. 勾選「顯示方程式」與「顯示 R 平方值」,圖上就會印出
y = 0.0504x − 0.0029 與 R² = 0.9990(等同本頁圖 4-1 的紅線)。4.3 r 與 r²:直線有多「直」?
- 相關係數 r(−1 ~ +1):r=+1 完美正相關。分析化學經驗法則:r ≥ 0.997 才算理想標準曲線(生物數據除外)
- 判定係數 r²:y 變異中能被 x 線性解釋的比例。r²=0.9990 → 0.10% 的變異來自隨機因素(Nielsen 4.4.2)
4.4 反推未知濃度與外插危機
Nielsen 的咖啡因 HPLC 曲線:y = 89.994x + 90.727(r²=0.9989),未知咖啡樣品波峰面積 4000 → 43.44 ppm 咖啡因。鈉曲線的未知樣品 y=0.555 → (0.555+0.0029)/0.0504 = 11.1 μg/mL。
x <- c(1, 3, 5, 10, 20)                    # Na 濃度 ug/mL
y <- c(.050, .140, .242, .521, .998)       # 發射值

fit <- lm(y ~ x)                            # 線性迴歸
coef(fit)          #> (Intercept) -0.00292 | x 0.05040
summary(fit)$r.squared   #> 0.9990
cor(x, y)                #> 0.9995

# 反推未知樣品 (y_obs = 0.555)
y_obs <- 0.555
(y_obs - coef(fit)[1]) / coef(fit)[2]   #> 11.1 ug/mL

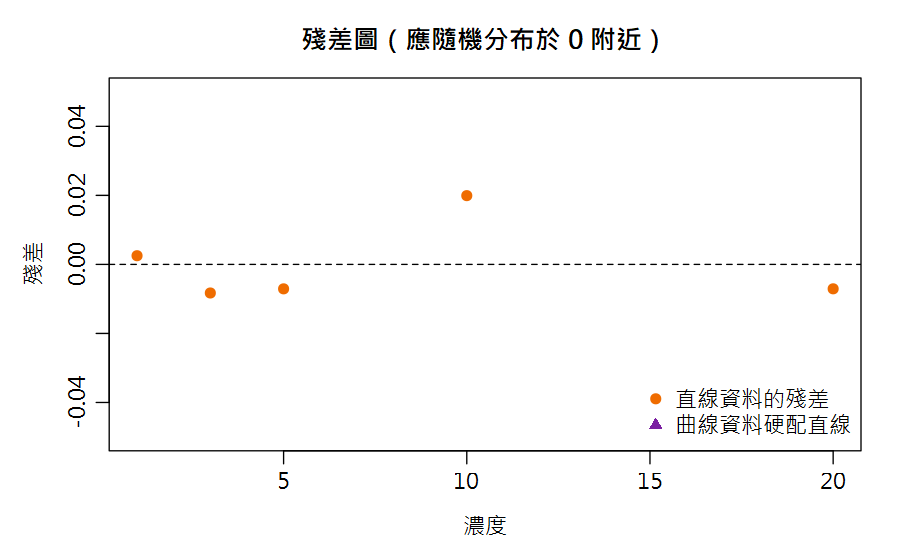
# 殘差檢查
residuals(fit)
#>      1        2        3        4        5
#>  0.0025 -0.0083 -0.0071  0.0199 -0.0071   (隨機散布,OK)

# 95% 信賴帶畫法
nx <- seq(1, 20, length.out = 100)
ci <- predict(fit, data.frame(x = nx), interval = "confidence")
matplot(nx, ci[, c("lwr","upr")], type="l", lty=2, col="grey40")
abline(fit, col="red"); points(x, y, pch=19)
(Intercept)            x
-0.002915945  0.050399480
[1] 0.9990253
[1] 0.9995125
(Intercept)
   11.06988
           1            2            3            4            5
0.002516464 -0.008282496 -0.007081456 0.019921144 -0.0070736574.5 進階:殘差呈喇叭狀怎麼辦——加權迴歸(WLS)
情境:前面的鈉曲線只跨 1–20 μg/mL。但 HPLC 測咖啡因常常一條線要從 1 ppm 用到 100 ppm—— 跨了兩個數量級。這時候會出現一個新問題:高濃度標準品的訊號大,它「抖動」的幅度也跟著大。 把殘差畫出來,左邊(低濃度)擠成一團、右邊(高濃度)散得很開,形狀像一支喇叭(或漏斗)。 這個現象叫異方差(heteroscedasticity)。
結果:整條線看起來很漂亮、r² 很高,但低濃度端反推出來的濃度,相對誤差特別大。 偏偏法規限量、LOQ 附近的樣品,正好都落在低濃度端。
怎麼判斷需要加權?兩個線索都要看:
- 每個濃度做重複(這裡每濃度 3 次),算各濃度的 SD:如果 SD 隨濃度一路變大,等變異假設就不成立
- OLS 殘差圖呈喇叭狀:殘差的散布隨預測訊號張開
「濃度範圍很寬」本身不是自動加權的理由,它只是提醒你要去檢查上面這兩件事。
# HPLC 咖啡因示例:5 個濃度,每個濃度做 3 次標準品
conc <- rep(c(1, 5, 10, 50, 100), each = 3)
area <- c(101, 99, 102,
          498, 505, 492,
          1005, 992, 1018,
          4930, 5070, 5005,
          9720, 10380, 10040)

# 診斷:每個濃度 3 次重複的 SD,是不是隨濃度一路變大?
round(tapply(area, conc, sd), 1)
    1     5    10    50   100
  1.5   6.5  13.0  70.1 330.1
解讀:SD 從 1 ppm 的 1.5 一路長到 100 ppm 的 330.1,相差 200 多倍—— OLS「每個點一樣可靠」的假設明顯不成立。
在 R 裡只要多給 lm() 一個 weights 引數。下面一次配三個候選模型(不加權、1/x、1/x²),
再把 15 筆標準品當成「未知樣品」反推回去,算每個濃度的平均回算相對誤差(%RE =(反推濃度 − 真實濃度)÷ 真實濃度 × 100):
# 三個候選模型:不加權、1/x、1/x^2
fit_ols <- lm(area ~ conc)
fit_1x  <- lm(area ~ conc, weights = 1 / conc)
fit_1x2 <- lm(area ~ conc, weights = 1 / conc^2)

coef(fit_ols)
coef(fit_1x)
coef(fit_1x2)

# 反推每筆標準品濃度,計算各濃度的平均回算偏差 (%)
backcalc <- function(fit) {
  (area - coef(fit)[1]) / coef(fit)[2]
}

bias_table <- data.frame(
  conc = conc,
  OLS = 100 * (backcalc(fit_ols) - conc) / conc,
  WLS_1x = 100 * (backcalc(fit_1x) - conc) / conc,
  WLS_1x2 = 100 * (backcalc(fit_1x2) - conc) / conc
)
print(aggregate(. ~ conc, data = bias_table, FUN = mean))

# 圖 1:若 OLS 殘差隨預測訊號張開,表示等變異假設可能不合適。
# 圖 2:WLS 要看 sqrt(weight) * residual 的加權殘差。
par(mfrow = c(1, 2))
plot(fitted(fit_ols), residuals(fit_ols), pch = 19,
     xlab = "預測訊號", ylab = "殘差", main = "OLS")
abline(h = 0, lty = 2)
plot(fitted(fit_1x2), sqrt(1 / conc^2) * residuals(fit_1x2), pch = 19,
     xlab = "預測訊號", ylab = "加權殘差", main = "WLS: 1/x^2")
abline(h = 0, lty = 2)
par(mfrow = c(1, 1))

# 補充:三個模型的 r^2 幾乎一樣 -> 不能用 r^2 選權重
round(sapply(list(OLS = fit_ols, WLS_1x = fit_1x, WLS_1x2 = fit_1x2),
             function(f) summary(f)$r.squared), 4)
(Intercept)        conc
  -3.788347  100.429368
(Intercept)        conc
 -0.2060136 100.3214663
(Intercept)        conc
  0.4315459 100.1518755
  conc          OLS     WLS_1x     WLS_1x2
1    1  4.008435138  0.5494477  0.08311906
2    5 -0.005010252 -0.6116307 -0.57065129
3   10  0.447545224  0.1984970  0.30450748
4   50 -0.318898364 -0.2831026 -0.12698019
5  100  0.074860821  0.1467887  0.31000493
    OLS  WLS_1x WLS_1x2
0.9989 0.9994 0.9996 解讀(看 conc = 1 那一列):
| 模型 | 截距 | 斜率 | 1 ppm 的 %RE | 100 ppm 的 %RE | r² |
|---|---|---|---|---|---|
| OLS(不加權) | −3.79 | 100.43 | +4.01 | +0.07 | 0.9989 |
| WLS 1/x | −0.21 | 100.32 | +0.55 | +0.15 | 0.9994 |
| WLS 1/x² | 0.43 | 100.15 | +0.08 | +0.31 | 0.9996 |
- 三條線的斜率幾乎一樣(100.2–100.4),差別在截距:OLS 的截距 −3.79 是被 100 ppm 那三個散得很開的點「拉」出來的。 1 ppm 的訊號只有 100 左右,截距差 4 個面積單位就等於偏了 +4.01%;同樣的 4 個單位對 100 ppm(訊號約 10000)根本看不出來。
- 加權之後,1 ppm 的 %RE 由 +4.01%(OLS)降到 +0.55%(1/x)、+0.08%(1/x²); 代價是高濃度端多一點點偏差(100 ppm:+0.07% → +0.31%),但全部濃度都還在 ±1% 以內。這就是加權的交換:用高濃度端一點點,換低濃度端一大截。
- 圖的看法:左圖 OLS 殘差愈往右愈張開(喇叭);右圖畫的是加權殘差 \(\sqrt{w_i}\times\)殘差,各濃度的散布應該變得差不多寬——如果還是喇叭,代表權重選得不夠。
另外兩個限制:x = 0 的空白點無法使用 1/x 或 1/x²(會除以 0);直接用 1/s² 當權重需要每個濃度有足夠多的重複,只做 3 次的 s² 並不穩定,所以實務上多用 1/x 或 1/x² 近似。
⬇ 下載本章 Excel 活頁簿 數據、公式、白話說明都排好了,打開就能算;改黃色儲存格試試看,最後一張工作表會幫你和 R 的答案對照。
Excel 的 SLOPE/INTERCEPT 沒有權重引數。但 1/x² 加權有個漂亮的等價寫法:把 y = ax + b 兩邊同除以 x,得到 y/x = a + b·(1/x), 對它做普通迴歸,就等於對原式做 1/x² 加權。濃度放A1:A15、面積放 B1:B15,C 欄輸入 =1/A1、D 欄輸入 =B1/A1 後下拉:| 結果 | Excel 公式 | 注意 |
|---|---|---|
| 斜率 a | =INTERCEPT(D1:D15,C1:C15) → 100.15 | 角色對調了:新式子的截距才是原來的斜率 |
| 截距 b | =SLOPE(D1:D15,C1:C15) → 0.43 |
lm(area ~ conc, weights = 1/conc^2) 相同。1/x 加權沒有這麼簡單的轉換寫法,但可以用 SUMPRODUCT 直接算加權最小平方(Σw、Σwx、Σwy、Σwx²、Σwxy)——本章 Excel 活頁簿的「WLS」工作表就是這樣做的,把權重欄改成 1/x 即可;資料多時仍建議用 R。📊 Excel 也會算:標準曲線迴歸
A1:A5(x)、儀器訊號放 B1:B5(y)。Excel 的 SLOPE/INTERCEPT 就是最小平方法,與 R 的 lm() 一致。| 任務 | Excel 公式 | 說明 |
|---|---|---|
| 斜率 a | =SLOPE(B1:B5,A1:A5) | 靈敏度 |
| 截距 b | =INTERCEPT(B1:B5,A1:A5) | 空白背景 |
| r² | =RSQ(B1:B5,A1:A5) | 貼線程度 |
| 反推未知濃度 | =(未知訊號−b)/a | x=(y−b)/a |
| 殘差 | =B1−(截距+斜率*A1) | 逐點下拉 |